Zlecasz Claude Code poprawkę w aplikacji. Agent analizuje repozytorium, zmienia kod i uruchamia testy. Dostajesz gotowy diff.
Tyle że nadal musisz sprawdzić wymagania, wychwycić brakujący przypadek brzegowy, poprosić o poprawkę, przejrzeć testy i dopilnować pull requesta.
Agent pracuje. Ty nadal koordynujesz cały proces.
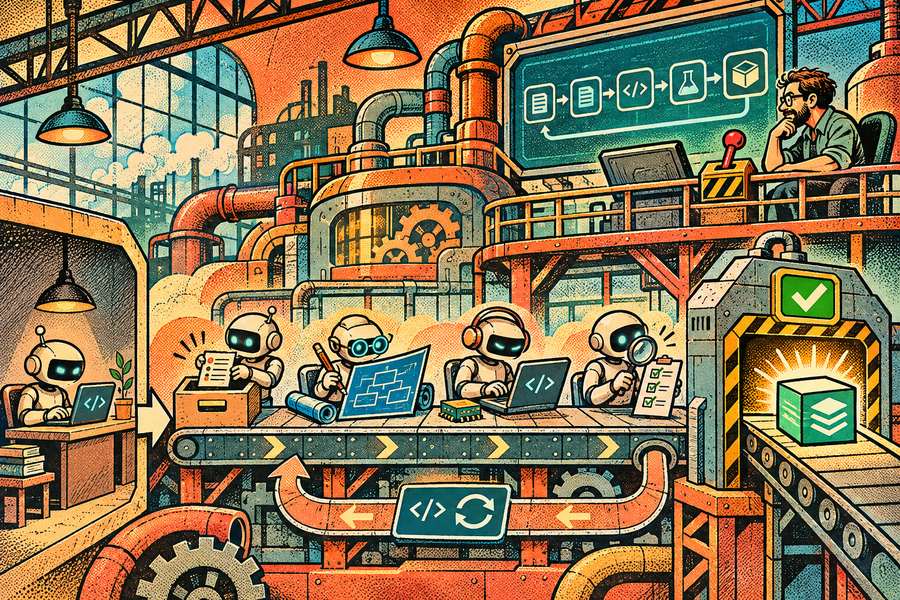
Fabryka AI (AI Software Factory) próbuje rozwiązać inny problem niż pojedynczy agent. Nie pyta tylko, jak szybciej napisać kod. Pyta, jak przeprowadzić zadanie od zgłoszenia do sprawdzonego rezultatu, bez ręcznego uruchamiania każdego kolejnego etapu.
W architekturze systemu ta różnica zmienia niemal wszystko.
Agent, zespół agentów i fabryka: trzy różne rzeczy
Chatbot podpowiada kod. Agent programistyczny może samodzielnie zmienić pliki, uruchomić testy i poprawić błąd. Dostaje cel i narzędzia, a potem działa w pętli: analiza, decyzja, wykonanie, obserwacja wyniku. Tak pracują m.in. Claude Code i Codex.
System wieloagentowy dzieli zadania między wykonawców: analityka, programistę czy recenzenta. Współpraca kilku modeli nie oznacza jednak, że ktoś pilnuje całego procesu.
Fabryka AI obejmuje również to, co dzieje się przed implementacją i po niej: przyjęcie zgłoszenia, specyfikację, kolejkę, stan zadań, testy, obsługę błędów, PR i decyzję o wdrożeniu.
O fabryce nie decyduje liczba agentów. Decyduje to, czy system potrafi przeprowadzić zadanie do sprawdzonego rezultatu.
W Building effective agents Anthropic rozróżnia workflow, w którym przebieg wyznacza kod, od agenta, który sam wybiera kolejne działania. Dobra fabryka wykorzystuje oba podejścia. Zdarzenia, statusy i limity warto obsługiwać deterministycznie, a modelowi zostawić pracę wymagającą interpretacji.
Od promptu do pracy proaktywnej
Agent nie musi czekać na otwarcie terminala. Jak opisuję w artykule Wyjdź z pętli, autonomię można stopniować:
| Tryb | Co robi człowiek? |
|---|---|
| In the loop | Uruchamia zadanie i prowadzi sesję |
| Near the loop | Otrzymuje wynik lub decyzję do zatwierdzenia |
| Out of the loop | Nadzoruje automatyczny proces, reaguje na wyjątki |
Zadania mogą przychodzić z GitHub Issues, webhooka, alarmu albo crona. Nie oznacza to prawa do automatycznego merge’a. Samodzielne rozpoczęcie pracy i prawo do wdrożenia to dwie różne decyzje.
W idei Tiny Software Factories dobrze widać tę granicę: Empty Factory daje środowisko i narzędzia, a Running Factory ma już konkretne wejście, wyzwalacz i wynik. Warto zacząć od jednego, dobrze zdefiniowanego problemu.
Jak wygląda jedno zadanie w fabryce?
Przykład z Angulara: filtr zamówień ma zapamiętywać status w URL, obsługiwać Wstecz i działać z klawiatury. Zwykły agent może napisać komponent. Fabryka powinna zadbać o cały przepływ:
- Przyjęcie. Zgłoszenie dostaje identyfikator. System weryfikuje źródło, odrzuca duplikaty i sprawdza, czy wymagania są kompletne.
- Specyfikacja. Agent analizuje routing i formularz, zapisuje kryteria akceptacji oraz niejasności. Nie zgaduje po cichu, jak ma działać historia przeglądarki.
- Plan i środowisko. Orkiestrator tworzy branch i izolowany Git worktree, przydziela narzędzia oraz limity czasu i kosztu.
- Implementacja. Agent zmienia kod, uruchamia TypeScript, lint i testy. Scenariusz Playwright sprawdza odświeżenie, Wstecz i klawiaturę.
- QA i poprawki. Niezależny recenzent porównuje wynik ze specyfikacją. Jeśli znajdzie regresję, zwraca jeden raport uwag, a system ponawia pracę w określonym limicie.
- PR i decyzja. Fabryka publikuje zmianę, dołącza wyniki CI i informację, czego nie sprawdzono. Człowiek zatwierdza merge, a system zapisuje przebieg zadania.
Stan nie może istnieć tylko w ostatniej wiadomości agenta. Przydatne statusy to queued → analyzing → implementing → reviewing → awaiting_approval → completed, a obok blocked, failed i cancelled. Każdy etap powinien zostawić artefakt, np. specyfikację, diff, raport testów lub werdykt.
Architektura: orkiestrator, workery i trwały stan
W Machinist oraz w opisanej na blogu demonstracji Owaina Lewisa widać podział znany z systemów rozproszonych.
Control plane przyjmuje zgłoszenia, prowadzi kolejkę, decyduje o kolejności i nadzoruje wyniki. To miejsce orkiestratora, polityk bezpieczeństwa, budżetów i historii wykonania.
Data plane wykonuje pracę: uruchamia agentów, shell, przeglądarkę, testy oraz odizolowane katalogi robocze. Jeden worker może realizować wiele kolejnych zadań, ale nie powinien dowolnie zmieniać reguł całej fabryki.
Orkiestrator pilnuje też zależności. Plan można zapisać jako DAG, skierowany graf acykliczny: test integracyjny zależy od gotowego API, ale jego scenariusz można przygotować wcześniej. Równoległość przyspiesza pracę tylko wtedy, gdy wykonawcy nie wchodzą sobie w drogę.
Obie warstwy mogą działać na jednym VPS-ie. Ważniejsze od liczby maszyn są trwałe identyfikatory zadań, checkpointy, kontrola ponowień i możliwość zatrzymania procesu. Panel sterowania powinien pokazywać, co aktualnie trwa i dlaczego coś utknęło, a nie tylko przesuwać kolorowe karty.
Harness engineering: model to nie całe środowisko
Skuteczność agenta zależy nie tylko od modelu. Harness to jego otoczenie: narzędzia, instrukcje, kontekst, uprawnienia i mechanizmy weryfikacji. W eksperymencie OpenAI z Codex zespół opisał około miliona linii wygenerowanego kodu i 1500 PR-ów w pięć miesięcy. To relacja autorów, nie niezależny benchmark jakości. Kluczowa była praca nad repozytorium, dokumentacją i automatycznymi kontrolami.
Przy projektowaniu pojedynczego wykonawcy pomaga Core Four, koncepcja opisana przez IndyDevDana w materiałach o Tiny Software Factories: kontekst, model, instrukcje i narzędzia. Każda rola powinna otrzymać tylko to, czego potrzebuje. Agent access parity, czyli możliwość wykonania operacji dostępnych użytkownikowi, nie może oznaczać nieograniczonych uprawnień.
Potrzebne są też dwa rodzaje pamięci. Wiedza o projekcie to np. AGENTS.md, ADR-y, kontrakty API i zasady architektury. Stan zadania mówi, co już zrobiono, które testy przeszły i dlaczego QA odrzucił zmianę. Pierwsza może żyć w repozytorium, druga w trwałym magazynie procesu.
Trwały agent. Dlaczego przywrócenie rozmowy nie wystarczy?
Załóżmy, że agent wykrył błąd 500, utworzył zgłoszenie, zapisał poprawkę i właśnie miał uruchomić testy. W tym momencie proces zostaje przerwany.
Zwykłe /resume może przywrócić historię rozmowy. Nie odpowiada jednak niezawodnie na pytania: czy zgłoszenie zostało naprawdę utworzone, czy commit zakończył się sukcesem i od jakiej operacji trzeba kontynuować.
W artykule o Pi Durable pokazuję różnicę między trwałością konwersacji a trwałością wykonania. Dokumentacja Pi Durable opisuje utrwalanie wpisów, wywołań narzędzi i stanu zadań, a także punkty kontrolne, z których można wznowić pracę po restarcie.
Potrzebujesz tu trzech niezależnych mechanizmów:
- Checkpoint: zapisuje zatwierdzony etap pracy i artefakty, do których można wrócić po awarii.
- Dedublikacja zdarzeń: identyfikator żądania, np.
requestId, pozwala rozpoznać ponowne dostarczenie tego samego zlecenia. - Idempotentne skutki uboczne: system sprawdza, czy zapis PR-a, komentarza lub operacja wdrożeniowa już nastąpiła, zanim spróbuje ją powtórzyć.
Ważny szczegół z Pi Durable: przerwane wywołania modeli można ponawiać, natomiast ponowne wykonanie narzędzia z efektem ubocznym wymaga świadomie określonej polityki. Trwałość nie gwarantuje wykonania zewnętrznej operacji dokładnie jeden raz.
Przykład? Zdarzenie o identyfikatorze incident-421 przychodzi dwa razy. Fabryka może wznowić to samo dochodzenie i wykorzystać istniejący PR. Nie powinna tworzyć dwóch zgłoszeń, dwóch branchy i dwóch wdrożeń. To drobiazg, dopóki rezultatem powtórzenia nie jest usunięcie danych.
Czy potrzeba wielu agentów? Przykład Claude Code
Nie. Osobne role mają sens, kiedy dają niezależną ocenę, ograniczone uprawnienia albo równoległość. Kilku recenzentów czytających ten sam prompt może równie dobrze powtórzyć ten sam błąd.
Konkretny schemat pokazuje fabryka ZazenCodes oparta na Claude Code. Jeden skill /factory orkiestruje siedmiu subagentów: spec writer, builder, recenzentów security, UX, UI i code, a na końcu approver.
Stan zadania zapisuje plik job.json. Wykonawcy tworzą osobne raporty o jednoznacznych wynikach, np. READY, PASS, CHANGES albo ESCALATE. Cztery recenzje ruszają dopiero po implementacji; builder otrzymuje ich komplet, nie pojedyncze uwagi w przypadkowej kolejności.
W tym szablonie są najwyżej dwie rundy poprawek po pierwszej implementacji. Trudne lub wrażliwe zmiany trafiają do człowieka. Git worktrees rozdzielają katalogi pracy, ale nie zapewniają izolacji uprawnień ani dostępu do sekretów.
To dobry przykład kontraktów i bramek jakości. Nie dowód, że siedem agentów zawsze działa lepiej niż dwóch. Kod i dokładny podział ról są dostępne w repozytorium ZazenCodes.
Narzędzia rozwiązują różne części problemu
Nie istnieje jeden obowiązkowy stos technologiczny. Warto rozdzielić narzędzia wykonawcze, warstwę orkiestracji i trwałość zadania.
| Rozwiązanie | Główne zastosowanie |
|---|---|
| Claude Code, Codex | Implementacja i testy w repozytorium |
| Tiny Software Factories | Mały proces uruchamiany zdarzeniem lub harmonogramem |
| ZazenCodes / Claude Code | Specyfikacja, builder, niezależne review |
| Pi Durable | Checkpointy i wznawianie pracy |
| Machinist | Kolejka, workery, historia przebiegów |
| OpenAI Symphony | Powiązanie ticketów z cyklem pracy agentów |
W Symphony jednostką pracy jest zgłoszenie, nie otwarty terminal. OpenAI informowało o wzroście liczby scalanych PR-ów o 500% w niektórych wdrożeniach. To obserwacja firmy, nie uniwersalna prognoza produktywności. Podobne delegowanie issue do PR umożliwia GitHub Copilot coding agent.
Narzędzia można łączyć, ale warto najpierw ustalić, której warstwy rzeczywiście brakuje. Jeśli problemem jest tylko review, budowanie całego control plane będzie kosztowną drogą na skróty.
Kontrola jakości i granice autonomii
Najdroższy błąd fabryki może powstać przed napisaniem pierwszej linijki kodu. Nieprecyzyjna specyfikacja sprawi, że kilka agentów bardzo sprawnie dostarczy niewłaściwą funkcję. Testy napisane na podstawie tych samych założeń mogą jeszcze potwierdzić pomyłkę.
Dlatego kryteria akceptacji muszą powstać przed implementacją, a QA powinno weryfikować je niezależnie. TypeScript, testy jednostkowe, E2E i kontrola dostępności sprawdzają różne aspekty zmiany. Zielony CI nie jest dowodem, że użytkownik dostał to, czego potrzebował.
Zakres uprawnień warto uzależnić od ryzyka:
- Niskie: odwracalna poprawka dokumentacji może przejść przez automatyczne kontrole.
- Średnie: typowa funkcjonalność może otrzymać automatycznie przygotowany PR, ale merge zatwierdza człowiek.
- Wysokie: płatności, autoryzacja, migracje danych i produkcyjne sekrety wymagają osobnych zgód i ograniczeń.
Treść ticketu, pobrany dokument czy zewnętrzny komentarz są nieufnymi danymi, nie instrukcjami sterującymi fabryką. Weryfikacja źródła zdarzeń, sandboxy, ograniczenia sieci i zasada najmniejszych uprawnień chronią system przed błędami oraz prompt injection. Człowiek powinien uczestniczyć tam, gdzie konsekwencje decyzji są trudne do cofnięcia, a nie przy każdym odczycie pliku.
Czy AI naprawdę przyspiesza programowanie?
Liczba wygenerowanych linii kodu i otwartych PR-ów wygląda atrakcyjnie w raporcie. Sama w sobie niewiele jednak mówi o wartości.
W badaniu METR z lipca 2025 roku 16 doświadczonych programistów realizowało 246 rzeczywistych zadań w dobrze znanych im projektach open source. Gdy mogli korzystać z ówczesnych narzędzi AI, wykonywanie zadań trwało średnio 19% dłużej.
Badanie nie dotyczyło pełnych autonomicznych fabryk ani najnowszych agentów. Nie dowodzi więc, że AI zawsze spowalnia pracę.
W aktualizacji z lutego 2026 roku METR opisało problemy z nowym eksperymentem: niektórzy developerzy nie chcieli pracować bez AI, a wybór zadań stawał się nierównomierny. Autorzy uznali, że wyniki nie dają wiarygodnego oszacowania aktualnego przyspieszenia.
Z kolei badanie produkcyjnych agentów opisane przez IBM Research objęło 306 praktyków z 26 dziedzin. Według autorów 68% badanych wdrożeń ograniczało działanie agenta do najwyżej dziesięciu kroków przed interwencją człowieka. Najczęściej wskazywanym problemem była niezawodność.
To nie są pomiary tej samej rzeczy, ale prowadzą do rozsądnego wniosku: większa autonomia i wyższa przepustowość nie są jeszcze dowodem na lepszy proces inżynierski.
Jak mierzyć skuteczność i doskonalić proces?
Warto patrzeć na zaakceptowane zadania, nie na liczbę PR-ów ani wygenerowanych linii kodu. Do każdego przebiegu zapisywałbym czas od zgłoszenia do akceptacji, koszt wszystkich wywołań, liczbę poprawek, wynik QA i regresje po wdrożeniu.
W demonstracji Machinist opisywanej przez Owaina Lewisa dostępne są historia przebiegów i zużycie tokenów. To dobry początek, ale sam czas czy koszt nie mówi jeszcze, czy kod jest poprawny.
Kolejny krok to evals: stały zestaw reprezentatywnych zadań i kryteriów oceny. Wtedy możesz porównać dwa modele, prompty lub konfiguracje review na podobnych przypadkach. W przeciwnym razie oszczędność może wynikać po prostu z łatwiejszego zgłoszenia.
Lewis proponuje też zastąpienie powtarzalnego pytania modelu o status CI zwykłym skryptem. To propozycja usprawnienia, nie potwierdzony w filmie wynik finansowy. Pokazuje jednak dobrą zasadę: operacje deterministyczne zostaw kodowi, interpretację modelowi.
Samodoskonalenie nie powinno oznaczać dowolnego przepisywania własnych reguł. Zdrowa pętla wygląda tak: pomiar → hipoteza → test na porównywalnych zadaniach → wdrożenie lub wycofanie. Polityki bezpieczeństwa pozostają pod oddzielną kontrolą.
Jak zbudować pierwszą fabrykę bez przerostu formy?
Nie zaczynałbym od kilkunastu agentów. Wybrałbym jedno powtarzalne zadanie, np. obsługę dobrze opisanych błędów w Angularze, i rozszerzał proces dopiero po sprawdzeniu wyników.
- Jeden wykonawca. Agent przygotowuje branch, poprawkę, testy i raport. Na początku każdy PR przechodzi ręczną ocenę.
- Specyfikacja i niezależny QA. Przed zmianą zapisujemy kryteria akceptacji. Po zmianie osobny etap sprawdza rezultat. Każda pętla poprawek ma limit.
- Trwały orkiestrator. Dodajemy kolejkę zadań, identyfikatory, checkpointy i bezpieczne ponawianie operacji. Zdarzenia mogą przychodzić z webhooka lub harmonogramu.
- Izolacja i równoległość. Worktrees rozdzielają pliki, a osobne uprawnienia chronią narzędzia i sekrety. Współbieżność uruchamiamy tylko dla niezależnych prac.
- Obserwowalność. Panel pokazuje kolejkę, blokady, koszty i raporty. Z czasem porównujemy wersje procesu na tych samych zadaniach.
Nie wszystko trzeba automatyzować. W małym projekcie dobrze skonfigurowany pojedynczy agent może być rozsądniejszy od systemu kolejkowego. Fabryka ma sens, gdy zadania powtarzają się regularnie, a ich wyniki można obiektywnie ocenić.
Przed uruchomieniem bez nadzoru
Sprawdziłbym sześć warunków:
- Wejście: uwierzytelnione zdarzenia i deduplikacja.
- Stan: możliwość wznowienia po awarii bez powtórzenia niebezpiecznych operacji.
- Granice: odizolowane środowiska, minimalne uprawnienia, limity kosztu i czasu.
- Jakość: testowalne kryteria, niezależna weryfikacja i dowody w raporcie.
- Kontrola: znane zasady eskalacji, zatrzymania pracy i zatwierdzania wdrożeń.
- Odzyskiwanie: logi audytowe oraz możliwość cofnięcia zmiany.
Jeśli tych elementów brakuje, lepiej pozostać w trybie near the loop. Automatyzacja powinna zmniejszać obciążenie, a nie tylko przenosić je na późniejsze debugowanie.
Co zostaje programiście?
Im więcej kodu wykonują agenci, tym większe znaczenie ma to, jak opisujemy problem i jak sprawdzamy rezultat.
Programista nadal musi rozumieć architekturę, testowanie, bezpieczeństwo, dostępność i konsekwencje zmian. Tyle że częściej będzie wykorzystywał tę wiedzę do projektowania reguł i procesów niż do ręcznego poprawiania każdego fragmentu kodu.
To przesunięcie od wykonywania pojedynczych operacji do projektowania środowiska, w którym wiele operacji może odbywać się bez ciągłego nadzoru.
Fabryka AI przesuwa pracę programisty z prowadzenia każdej sesji na projektowanie reguł, według których oprogramowanie powstaje i przechodzi kontrolę.
Agent może napisać kod. Fabryka ma dostarczyć sprawdzalny rezultat.
Powiązane artykuły na The-Bart
To kompendium zbiera mechanizmy, które wcześniej analizowałem osobno. Jeżeli potrzebujesz szczegółów implementacji lub chcesz obejrzeć konkretne demonstracje, warto zajrzeć do:
- Tiny Software Factories: jak zbudować małą, proaktywną fabrykę do jednego problemu i czym różni się pusty szablon od działającego procesu.
- Wyjdź z pętli: tryby in-loop, near-loop i out-of-loop, trwałe środowisko oraz wyzwalacze.
- Pi Durable: checkpointy, reakcja na incydenty, wznowienia i idempotentność.
- Fabryka Claude Code: siedem ról, format raportów, równoległe review i worktrees.
- Fabryka, która uczy się na własnych błędach: Machinist, control/data plane, metryki i ewaluacje.
Każdy z tych tekstów przedstawia konkretne podejście lub demonstrację. Tutaj łączę je w model architektury, który można dostosować do własnego repozytorium.
Źródła
- Anthropic, Building effective agents (19 grudnia 2024): różnica między workflow a agentem oraz praktyczne wzorce orkiestracji.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world (11 lutego 2026): opis eksperymentu z repozytorium rozwijanym przez Codex, zasad architektury i automatycznych kontroli.
- OpenAI, An open-source spec for Codex orchestration: Symphony (27 kwietnia 2026): podejście do orkiestracji oparte na zgłoszeniach oraz wyniki opisane przez zespoły wdrożeniowe.
- GitHub Docs, Kick off a task with Copilot agents on GitHub: zakres działania agenta obsługującego issue i pull request.
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (10 lipca 2025): kontrolowane badanie czasu realizacji zadań.
- METR, We are Changing our Developer Productivity Experiment Design (24 lutego 2026): ograniczenia późniejszego eksperymentu.
- IBM Research, Measuring Agents in Production (23 kwietnia 2026): badanie praktyk i ograniczeń produkcyjnych systemów agentowych.
- ZazenCodes, Build Your Own AI Software Factory with Claude Code, kod demonstracyjny: siedem ról, kontrakty artefaktów i ograniczenia procesu.
- Pi Durable, dokumentacja eksperymentalnej biblioteki: trwałość stanów zadań, checkpointy oraz reguły ponowień.
- Owain Lewis, Machinist, repozytorium projektu: architektura i infrastruktura orkiestracji.
- Owain Lewis, I Built A Self-Improving AI Software Factory, demonstracja: monitorowanie pracy agentów i pomysł na ewaluację procesu.