Masz agenta, który umie pisać kod, analizować architekturę, naprawiać testy, robić code review i sprawdzać dostępność. Prosisz go o audyt formularza w Angularze. Dostajesz kilkanaście uwag, ale część jest ogólna, część nie dotyczy projektu, a jednej ważnej rzeczy nie zauważył: komunikat błędu nie jest powiązany z polem formularza.
Co zrobić? Podłączyć mocniejszy model? Dodać pięciu agentów? A może zaprojektować jednego, który zna cel audytu, potrafi sięgnąć do właściwej dokumentacji i wie, po czym poznać, że skończył?
To właśnie sens specjalizacji. I wbrew popularnej intuicji nie polega ona na magicznym ograniczeniu „myślenia” LLM-a do jednej dziedziny.
Co właściwie specjalizujemy?
W typowej implementacji nie zmieniamy wag modelu. Ten sam LLM może obsługiwać agenta od dostępności, analityka wymagań i redaktora technicznego. Zmieniamy warunki, w których pracuje.
Warto rozróżnić trzy poziomy:
| Mechanizm | Co dodajemy? | Co to daje? |
|---|---|---|
| Persona | „Jesteś ekspertem od WCAG” | Sugeruje styl i perspektywę, ale nie zapewnia kompetencji |
| Skill / specjalizacja zadaniowa | Procedurę, referencje, kryteria akceptacji, szablon wyniku | Prowadzi model przez konkretną klasę zadań |
| Subagent | Osobne wywołanie agenta, własny kontekst i narzędzia, kontrakt wyniku | Izoluje pracę i pozwala delegować ją innemu wykonawcy |
Jeszcze czymś innym jest fine-tuning, czyli dodatkowe trenowanie modelu, oraz RAG (retrieval-augmented generation), czyli dobieranie potrzebnych materiałów z zewnętrznych źródeł podczas wykonywania zadania. Można połączyć te techniki, ale do pierwszej specjalizacji nie trzeba trenować własnego modelu.
Zamiast wkładać całą bibliotekę dokumentacji do promptu, lepiej udostępnić agentowi indeks źródeł i pobierać konkretne fragmenty wtedy, gdy są potrzebne. To nie zawsze zmniejszy liczbę tokenów, lecz daje kontrolę nad ich przydatnością.
Czy to naprawdę działa? Badania studzą entuzjazm
Tytuł eksperta nie wystarczy
W pracy „When a Helpful Assistant Is Not Really Helpful” z EMNLP 2024 badacze sprawdzili 162 persony na czterech rodzinach modeli i 2410 pytaniach faktograficznych. Same role w promptach systemowych nie poprawiały systematycznie wyników względem wariantu bez persony.
To nie dowód, że każda instrukcja jest bezwartościowa. Badanie dotyczyło przede wszystkim etykiet ról, nie kompletnego agenta z narzędziami i testami. Ale hasło „jesteś seniorem z 20-letnim doświadczeniem” zdecydowanie nie jest strategią jakości.
Dobre procedury potrafią pomóc, ale zależy gdzie
SkillsBench (2026) porównał zadania wykonywane bez dodatkowych skilli, z przygotowanymi przez ludzi oraz ze skillami wygenerowanymi automatycznie. W tym benchmarku dobrane skille podniosły średni odsetek zaliczonych zadań o 16,6 punktu procentowego. Efekt zależał jednak od konfiguracji i zadania, dlatego samej średniej nie warto przenosić na konkretny projekt.
Jeszcze bardziej trzeźwiący jest SWE-Skills-Bench z marca 2026. Autorzy ocenili 49 skilli programistycznych: 39 nie przyniosło poprawy odsetka zaliczonych zadań, a średni wzrost wyniósł tylko 1,2% według miary badania. Siedem skilli dało wyraźne korzyści (do 30%), a trzy pogarszały wyniki (do 10%), między innymi przez instrukcje niedopasowane do wersji projektu.
Te prace nie przeczą sobie wprost. Badają inne zestawy zadań, inne konfiguracje i inne sposoby definiowania sukcesu. Łączy je bardziej praktyczny wniosek: wartość skilla trzeba wykazać na konkretnych zadaniach, a nie wywnioskować z jego długości.
Więcej kontekstu może przeszkadzać
W badaniu ETH Zürich „Evaluating AGENTS.md” kontekstowe pliki repozytorium nie przyniosły ogólnej poprawy skuteczności agentów kodujących, za to zwiększały koszt inferencji o ponad 20%. Agenci częściej eksplorowali pliki i wykonywali dodatkowe działania. Samo przestrzeganie instrukcji nie oznaczało lepszego rozwiązania.
Wniosek nie brzmi „usuń AGENTS.md”. Trzymaj w nim wymagania, których agent nie wywnioskuje sam z projektu, a nie historię firmy i katalog wszystkich możliwych dobrych praktyk.
Jak zbudować wyspecjalizowanego agenta: przykład z Angulara
Zaprojektujmy audytora dostępności formularzy, zamiast kolejnego „eksperta od wszystkiego”. Jego zadaniem nie jest napisać całą aplikację od nowa, tylko znaleźć konkretne problemy i przedstawić sposób ich sprawdzenia.
Zacząłbym od kontraktu:
- Wejście: ścieżka do komponentu, powiązane szablony i style oraz informacja o docelowym standardzie dostępności.
- Zakres: etykiety pól, nazwy dostępne, komunikaty błędów, obsługa klawiatury i zarządzanie focusem.
- Źródła: aktualne WCAG 2.2, WAI-ARIA Authoring Practices i konwencje konkretnego repozytorium.
- Narzędzia: odczyt kodu i dokumentacji, testy automatyczne, przeglądarka. Bez prawa do samodzielnego wdrożenia.
- Wynik: lista usterek z lokalizacją, dowodem, wpływem na użytkownika, proponowaną poprawką i sposobem weryfikacji.
Konfiguracja nie musi być długa. Przykładowy szkielet pliku SKILL.md:
---
name: angular-form-a11y-review
description: Audyt dostępności formularzy Angular
---

# Cel
Sprawdź wskazany formularz pod kątem dostępności.
Zwracaj tylko problemy powiązane z analizowanym kodem.

# Procedura
1. Odczytaj komponent, szablon i powiązane style.
2. Ustal zachowanie formularza oraz stanów błędów.
3. Sprawdź odpowiednie kryteria WCAG i wzorce WAI-ARIA.
4. Wykonaj dostępne testy i odróżnij wynik testu
   od hipotezy wymagającej ręcznego sprawdzenia.
5. Zwróć problemy z dowodami i konkretnymi poprawkami.

# Format wyniku
Dla każdego problemu: plik i miejsce, opis, źródło,
propozycja poprawki, metoda weryfikacji.
Jeżeli czegoś nie udało się sprawdzić, napisz to wprost.
Ten plik nie czyni modelu specjalistą od dostępności w sensie naukowym. Daje mu procedurę postępowania i kryteria oceny pracy. W prawdziwym projekcie rozbudowałbym go o sprawdzone przykłady dobrych i błędnych komponentów oraz o skrypty uruchamiające testy.
Automatyczne testy dostępności nie wykrywają wszystkich problemów, więc agent nie powinien deklarować pełnej zgodności z WCAG tylko dlatego, że narzędzie zwróciło zero błędów.
Co powinien widzieć agent, a co zostawić poza kontekstem?
Najprostszy wariant nie wymaga jeszcze subagenta. Jednemu modelowi przekazujesz zadanie, a umiejętność i materiały udostępniasz wtedy, gdy są potrzebne. Dopiero po wykonaniu pracy sprawdzasz wynik.
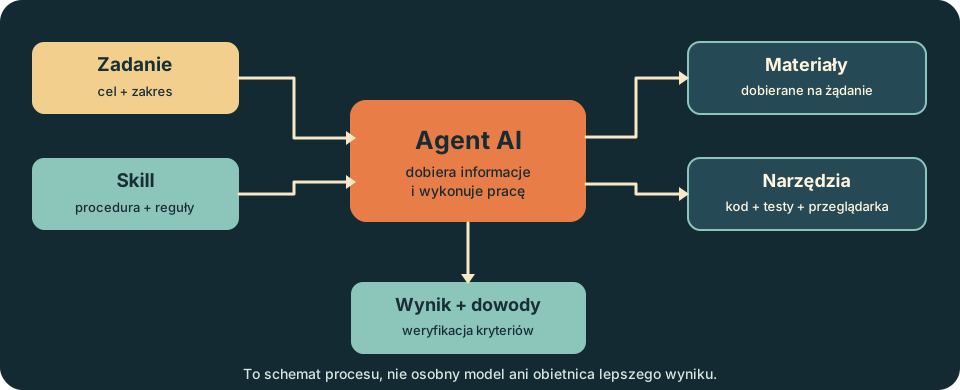
Kluczowe jest rozdzielenie wiedzy stałej (procedura i ograniczenia), wiedzy pobieranej na żądanie (konkretne wymagania WCAG, fragmenty repozytorium) oraz wyniku (raport i dowody). Gdy dokumentacja się zmieni, aktualizujesz źródło, nie całą osobowość agenta.
Warto wersjonować także skille. W pracy „How Agent Skills Evolve” z 3 listopada 2026 autorzy analizują dziesiątki tysięcy skilli z GitHuba i wskazują m.in. redundancję oraz utrzymywanie instrukcji związanych z konkretnymi projektami jako wyzwania. To obserwacyjne badanie ekosystemu, a nie test jakości pojedynczego agenta, ale dobrze pokazuje koszt utrzymania takich pakietów wiedzy.
Kiedy warto wydzielić osobnego subagenta?
To osobna decyzja architektoniczna. Skill to pakiet sposobu pracy; subagent to wykonawca z własną sesją, kontekstem i często osobnymi narzędziami. Możesz mieć wiele skilli w jednym agencie albo jednego subagenta korzystającego z jednego skilla.
Wyodrębnienie subagenta ma sens, gdy zadanie da się zakończyć samodzielnie: np. audyt dostępności, przegląd zależności albo weryfikacja testów. Wtedy agent nadrzędny otrzymuje krótki raport zamiast całej historii eksploracji repozytorium. Anthropic opisuje takie izolowanie kontekstu w materiale o context engineering.
Nie ma jednak powodu mnożyć wykonawców tylko dla efektownej listy ról. Badacze Google w „Towards a Science of Scaling Agent Systems” (2026) porównali 180 konfiguracji. Wielu agentów pomagało zwłaszcza przy zadaniach równoległych, ale pogarszało wyniki w części zadań sekwencyjnych. To wyniki konkretnych benchmarków, nie uniwersalne procenty dla programowania.
W praktyce: najpierw jeden agent ze sprawdzonym skillem. Osobnego subagenta dodaj, jeśli potrzebujesz niezależnego kontekstu, równoległego wykonania albo odseparowania narzędzi i uprawnień. Delegacja wprowadza koszt przekazania informacji, kolejne wywołania i nowe miejsca, w których coś może pójść źle.
Jak sprawdzić, czy specjalizacja działa w Twoim repozytorium?
Nie porównuj jednego „udanego demo” z jednym nieudanym promptem. Przygotuj kilka reprezentatywnych formularzy i trzy warianty tego samego zadania:
| Wariant | Co dostaje model? |
|---|---|
| A. Ogólny | Cel audytu i dostępne podstawowe narzędzia |
| B. Ze skillem | To samo, dodatkowo procedura i dobrane materiały |
| C. Subagent | Kontrakt z wariantu B, lecz w osobnej sesji, z odizolowanym kontekstem |
Utrzymaj ten sam model, wersję repozytorium i kryteria oceny. Powtórz próby, bo pojedyncze uruchomienie potrafi być przypadkowe. Zapisuj wykryte potwierdzone problemy, fałszywe alarmy, pominięcia, koszt tokenów, czas i liczbę ręcznych poprawek. Oddziel poprawność raportu od liczby jego punktów.
Zwróć uwagę na uczciwe porównanie: osobny subagent może zużyć większy budżet obliczeniowy. Jeśli ma go więcej, mierz również jakość przy podobnym koszcie, inaczej nie dowiesz się, czy pomogła architektura, czy po prostu dodatkowa praca modelu.
Przy odrobinie dyscypliny zyskujesz odpowiedź ważniejszą od kolejnej oceny modelu: czy ta konkretna specjalizacja poprawia ten konkretny proces na tyle, by opłacało się ją utrzymywać?
Specjalista to nie nazwa stanowiska
Wyspecjalizowany agent nie musi być osobnym modelem ani nawet osobnym procesem. Najpierw jest dobrze opisanym zadaniem z dostępnymi materiałami i sprawdzalnym wynikiem. Dopiero później, jeśli pomiary to uzasadnią, staje się osobnym członkiem zespołu agentów.
Najdroższy błąd to zbudować strukturę dziesięciu „ekspertów”, zanim sprawdzisz, czy jeden z nich rozwiązuje problem lepiej niż zwykły model.
Nie projektuj agentowi imponującego stanowiska. Zaprojektuj mu pracę, którą da się rzetelnie ocenić.
Podstawą artykułu są badania Zheng i in. (EMNLP 2024), SkillsBench (2026), SWE-Skills-Bench (2026), Gloaguen i in. (2026), Google Research (2026) oraz dokumentacja i praktyki Anthropic. To autorska synteza źródeł, nie opis samodzielnie przeprowadzonego eksperymentu.